Optimierung von RTO und RPO: 10 bewährte Verfahren
Jede Minute der Ausfallzeit zählt. Für Unternehmen kann die Fähigkeit zur schnellen Wiederherstellung darüber entscheiden, ob ein Vorfall zu einem kleinen Rückschlag oder zu einer ausgewachsenen Krise wird. Deshalb sind Recovery Time Objectives (RTOs) und Recovery Point Objectives (RPOs) wichtige Kennzahlen für jedes IT-Team und jeden MSP. Sie legen fest, wie schnell Systeme wiederhergestellt werden müssen und wie viele Daten verloren gehen dürfen, bevor das Unternehmen die Auswirkungen zu spüren bekommt. Wenn diese Benchmarks effektiv verwaltet werden, helfen sie Unternehmen dabei, kritische Datenverluste zu verhindern, Betriebsunterbrechungen zu minimieren und eine dauerhafte Widerstandsfähigkeit gegen unerwartete Ereignisse aufzubauen.
Um die Grundlagen von RTO und RPO zu verstehen und zu erfahren, wie sie die Planung der Geschäftskontinuität beeinflussen, lesen Sie unseren umfassenden Leitfaden: RTO und RPO: Was ist der Unterschied und warum sind sie wichtig?
In diesem Artikel gehen wir über die Grundlagen hinaus und konzentrieren uns auf die 10 besten Praktiken zur Optimierung von RTO und RPO. Diese praktischen Strategien helfen Unternehmen und MSPs dabei, ihre Wiederherstellungsziele zu verfeinern, den Datenschutz zu stärken und eine konstante Betriebszeit aufrechtzuerhalten, selbst wenn eine Katastrophe eintritt.
Bevor wir beginnen, nehmen Sie sich bitte ein paar Minuten Zeit, um zu erfahren, welche Kosten Ausfallzeiten für Sie oder die Unternehmen Ihrer Kunden tatsächlich verursachen könnten. Nutzen Sie den Rechner für Wiederherstellungszeit und Ausfallkosten, um potenzielle Verluste durch Ausfälle oder Datenunterbrechungen abzuschätzen und wertvolle Einblicke zu gewinnen, wie optimierte Wiederherstellungsziele Ihren Gewinn direkt schützen können.
10 bewährte Verfahren zur Verbesserung von RTO und RPO
Ziel der Optimierung von RTO und RPO ist es, eine Kontinuitäts- und Wiederherstellungsstrategie zu entwickeln, die kritische Daten schützt und den Geschäftsbetrieb auch während einer Störung aufrechterhält. Sehen wir uns die 10 Best Practices an, die Unternehmen und MSPs bei der Feinabstimmung ihrer RTO und RPO helfen. Diese bewährten Taktiken zeigen, wie man RTO und RPO von theoretischen Metriken in messbare, erreichbare Ergebnisse umwandelt - und wie BCDR-Lösungen wie die von Datto die Umsetzung dieser Taktiken erheblich erleichtern.
1. Kritische Daten und Systeme priorisieren
Nicht jedes System oder jeder Datensatz verdient den gleichen Dringlichkeitsgrad für die Wiederherstellung. Um realistische und effektive RTO- und RPO-Ziele festzulegen, müssen Unternehmen zunächst ermitteln, welche Workloads wirklich unternehmenskritisch sind.
Beginnen Sie mit einer Business Impact Analysis (BIA), um festzustellen, welche Anwendungen, Datenbanken und Dienste die größten Auswirkungen auf den täglichen Betrieb haben. Einige Systeme, wie z. B. Finanzverarbeitungsplattformen oder Kundendatenbanken, erfordern nahezu keine Ausfallzeiten und minimale Datenverluste. Andere, wie das interne Berichtswesen oder archivierte Datensätze, können längere Wiederherstellungszeiten und weniger häufige Backups vertragen.
Das Kassensystem einer Einzelhandelskette könnte beispielsweise eine RTO von 15 Minuten und eine RPO von fünf Minuten erfordern, um verlorene Transaktionen zu vermeiden. Die Marketing-Analyseplattform hingegen könnte mit einem RTO von vier Stunden und einem RPO von einer Stunde gut funktionieren.
Die Priorisierung stellt sicher, dass die Ressourcen dort eingesetzt werden, wo sie am wichtigsten sind, so dass IT-Teams und MSPs ein Gleichgewicht zwischen Ausfallsicherheit und Kosteneffizienz herstellen können.
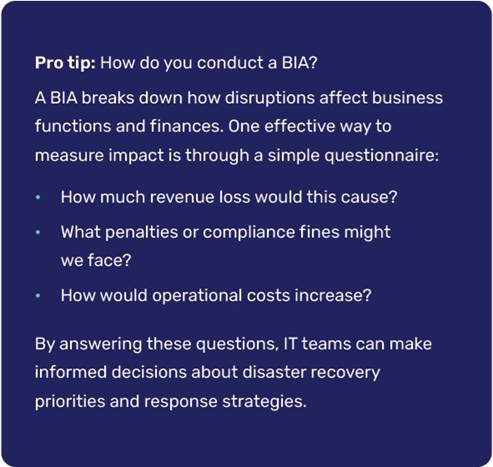
Abb. 1: Wie man eine BIA durchführt
2. Erhöhen Sie die Häufigkeit der Datensicherungen
Häufige Backups verringern das Risiko von Datenverlusten zwischen den Wiederherstellungspunkten. Je kürzer die Abstände zwischen den Backups sind, desto geringer sind die potenziellen Auswirkungen eines Systemausfalls.
Mit modernen Backup-Technologien können Unternehmen Backups im Fünf-Minuten-Takt planen und so sicherstellen, dass selbst bei einem unerwarteten Ausfall nur ein Minimum an Daten verloren geht. Dieser Ansatz ist besonders wertvoll für datenintensive Umgebungen wie E-Commerce- oder Finanzsysteme, bei denen schon wenige Minuten fehlender Informationen echte geschäftliche Konsequenzen haben können.
3. Sicherungen zur Redundanz replizieren
Wenn Sie sich auf einen einzigen Backup-Speicherort verlassen, sind Ihre Daten anfällig. Durch die Replikation von Backups in mehreren Umgebungen - lokal, in der Cloud und in hybriden Umgebungen - wird sichergestellt, dass die Daten auch dann zugänglich bleiben, wenn ein Standort oder ein System ausfällt. Dieser Ansatz reduziert nicht nur den Datenverlust, sondern verkürzt auch die Wiederherstellungszeit, da mehrere Wiederherstellungspfade zur Verfügung stehen.
Strategien zur Stärkung der Redundanz:
- Befolgen Sie die 3-2-1-1-0-Sicherungsregel: Bewahren Sie drei Kopien Ihrer Daten auf zwei verschiedenen Speichermedien auf, wobei eine Kopie außerhalb des Standorts, eine unveränderlich oder offline gespeichert sein sollte und durch Tests sichergestellt sein muss, dass keine Sicherungsfehler vorliegen. Erfahren Sie mehr über die moderne 3-2-1-1-0-Sicherungsregel.
- Geografische Verteilung nutzen: Speichern Sie Backups in verschiedenen physischen Standorten oder Cloud-Regionen, um sich vor regionalen Ausfällen oder Naturkatastrophen zu schützen.
- Nutzen Sie die Vorteile der hybriden Replikation: Kombinieren Sie lokale Appliances für eine schnelle lokale Wiederherstellung mit Cloud-Replikation für langfristige Ausfallsicherheit.
Die Replikation sorgt für echte Ausfallsicherheit und stellt sicher, dass kein einziger Fehler, Ausfall oder Vorfall Ihre Fähigkeit beeinträchtigt, Daten schnell und sicher wiederherzustellen.
4. Verwenden Sie unveränderliche, extern gespeicherte Backups
Moderne Ransomware zielt nicht nur auf Produktionssysteme ab - sie greift auch die Backup-Infrastruktur an. Wenn diese Backups verändert oder gelöscht werden können, wird eine Wiederherstellung unmöglich. Unveränderliche Backups verhindern dieses Risiko, indem sie die Backup-Daten sperren, sodass sie für eine bestimmte Aufbewahrungszeit nicht geändert, überschrieben oder gelöscht werden können.
Die Unveränderlichkeit wird durch eine Mischung aus softwaredefinierten Richtlinien und Speicherplattformfunktionen durchgesetzt. Diese Kontrollen stellen sicher, dass die Daten genau so bleiben, wie sie zum Zeitpunkt der Sicherung waren, unabhängig von Benutzerfehlern, Malware-Infektionen oder Manipulationen durch Insider. So entsteht jedes Mal ein sauberer, verifizierbarer Wiederherstellungspunkt - ein wesentlicher Schutz gegen moderne Cyberbedrohungen.
Wenn Sie mehr darüber erfahren möchten, wie Unveränderlichkeit die Sicherheit von Backups erhöht, lesen Sie unseren Leitfaden zum Thema „Unveränderliche Backups“.
5. Sicherungs- und Wiederherstellungsprozesse automatisieren
Manuelle Sicherungs- und Wiederherstellungsschritte können die Reaktionszeiten verlangsamen und kostspielige Fehler verursachen. Die Automatisierung stellt sicher, dass jeder Prozess - von der Datenerfassung bis zur vollständigen Systemwiederherstellung - schnell, konsistent und planmäßig abläuft. Durch die Reduzierung manueller Eingriffe können IT-Teams und MSPs eine zuverlässige Wiederherstellungsleistung aufrechterhalten, die mit den festgelegten RTO- und RPO-Zielen übereinstimmt.
Schlüsselbereiche, in denen Automatisierung die Zuverlässigkeit erhöht:
- Automatisierte Planung: Stellt sicher, dass Backups in genauen Intervallen durchgeführt werden, ohne dass manuelle Auslöser erforderlich sind, wodurch ein kontinuierlicher und vorhersehbarer Datenschutz gewährleistet wird.
- Automatisierte Überprüfung: Überprüft die Integrität jeder Sicherung mithilfe integrierter Prüfungen oder Testwiederherstellungen und stellt so sicher, dass die Wiederherstellungspunkte bei Bedarf einsatzbereit sind.
- Automatisiertes Failover: Koordiniert die nahtlose Systemwiederherstellung in Standby-Umgebungen oder in der Cloud, minimiert Ausfallzeiten und gewährleistet eine rasche Wiederaufnahme des Betriebs.
Mit diesen Funktionen verwandelt die Automatisierung die Wiederherstellung von einem reaktiven Prozess in eine kontrollierte, wiederholbare Routine, die die Wiederherstellungsziele jedes Mal erfüllt.
6. Sicherungen überwachen, überprüfen und validieren
Selbst die häufigsten Backups verlieren an Wert, wenn sie nicht wiederhergestellt werden können. Kontinuierliche Überwachung und Überprüfung stellen sicher, dass Backups erfolgreich abgeschlossen werden, nicht beschädigt werden und bei Bedarf vollständig wiederherstellbar sind. Proaktive Überwachung hilft, Probleme zu erkennen - wie fehlgeschlagene Backup-Jobs, unvollständige Replikationen oder beschädigte Dateien - lange bevor sie die Wiederherstellungsziele gefährden.
Diese Praxis ist eng mit der 3-2-1-1-0-Backup-Strategie verbunden, bei der die letzte "0" für null Backup-Fehler steht. Um diese Null zu erreichen, ist eine routinemäßige automatische Überprüfung erforderlich.
Die Backup-Überprüfung gibt IT-Teams und MSPs volles Vertrauen in ihre Datensicherheitsmaßnahmen. Um zu erfahren, wie eine fortschrittliche Backup-Überprüfung Ihre Datensicherheit stärken kann, werfen Sie einen Blick auf die fortschrittliche Backup-Überprüfung von Datto.
7. Virtualisierung für eine sofortige Wiederherstellung nutzen
Die Virtualisierung hat die Notfallwiederherstellung revolutioniert, da Systeme direkt aus Backups gestartet werden können. Anstatt auf vollständige Systemwiederherstellungen oder langwierige Datenübertragungen zu warten, können IT-Teams virtuelle Maschinen innerhalb weniger Minuten aus aktuellen Backup-Images starten. Diese Fähigkeit reduziert die Ausfallzeiten drastisch und hilft dabei, aggressive RTO-Ziele zu erreichen.
Die Flexibilität, sowohl lokal als auch in der Cloud zu virtualisieren, gewährleistet kontinuierliche Verfügbarkeit, unabhängig davon, wo ein Ausfall auftritt. Die lokale Virtualisierung unterstützt die sofortige Wiederherstellung bei Unterbrechungen vor Ort, während die Cloud-Virtualisierung ein Sicherheitsnetz außerhalb des Standorts bietet, wenn der primäre Standort beeinträchtigt ist. Zusammen bilden sie einen nahtlosen Wiederherstellungsrahmen, der den Betrieb aufrechterhält, während im Hintergrund eine vollständige Wiederherstellung durchgeführt wird.
8. Automatisches Failover implementieren
Wenn es zu einem Ausfall kommt, zählt jede Sekunde. Automatisiertes Failover eliminiert die Verzögerungen durch manuelle Eingriffe, indem der Betrieb sofort auf Standby-Systeme oder eine sekundäre Infrastruktur verlagert wird. Dadurch wird sichergestellt, dass kritische Anwendungen verfügbar bleiben, selbst wenn die primäre Umgebung ausfällt.
Durch die Verwendung vordefinierter, getesteter Workflows minimiert automatisiertes Failover menschliche Fehler und bietet einen konsistenten Wiederherstellungsprozess, der wichtige Dienste online hält. Ob durch Failover-Clustering oder Cloud-basierte Disaster-Recovery-Orchestrierung, die Automatisierung gewährleistet Kontinuität ohne Unterbrechung.
Wenn Sie mehr darüber erfahren möchten, wie Failover die Geschäftskontinuität und eine schnelle Wiederherstellung unterstützt, lesen Sie unseren Blogbeitrag darüber, was Failover ist und wie es funktioniert.
9. Führen Sie regelmäßig Tests zur Notfallwiederherstellung durch
Selbst der fortschrittlichste Wiederherstellungsplan kann scheitern, wenn er nicht getestet wird. Regelmäßige Disaster Recovery (DR)-Tests stellen sicher, dass Ihre Backups, Recovery-Workflows und Infrastruktur im Ernstfall genau so funktionieren wie vorgesehen.
Die Tests bestätigen, dass die RTO- und RPO-Ziele unter realen Bedingungen erreicht werden können, und decken gleichzeitig Lücken in Verfahren, Konfigurationen oder Dokumentation auf. Es hilft den Teams, zuversichtlich, vorbereitet und bereit zu sein, schnell zu reagieren, wenn eine Störung auftritt.
Geplante und ungeplante Tests – in Kombination mit Nachbesprechungen – ermöglichen eine kontinuierliche Verbesserung und stellen sicher, dass sich die Wiederherstellungsprozesse parallel zu geschäftlichen und technologischen Veränderungen weiterentwickeln. Weitere Informationen zu verschiedenen DR-Testszenarien und Testmethoden finden Sie in unserem Leitfaden zu Disaster-Recovery-Tests.
10. Überprüfung und Verfeinerung von Wiederherstellungsplänen
Die Wiederherstellungsplanung ist keine einmalige Angelegenheit, sondern ein kontinuierlicher Prozess. Wenn Ihr Unternehmen wächst und sich die Technologien weiterentwickeln, müssen sich auch die Wiederherstellungsziele weiterentwickeln. Die regelmäßige Überprüfung Ihrer Disaster Recovery- und Business Continuity-Pläne stellt sicher, dass Ihre RTO- und RPO-Ziele realistisch, relevant und erreichbar bleiben.
Bewerten Sie die Wiederherstellungsleistung nach jedem Test oder Vorfall und berücksichtigen Sie dabei neue Systeme, Workflows oder Compliance-Anforderungen. Durch die Einbeziehung wichtiger Interessengruppen in diese Überprüfungen werden die Wiederherstellungsprioritäten mit den Unternehmenszielen in Einklang gebracht.
Die ständige Weiterentwicklung sorgt für eine kontinuierliche Verbesserung und hilft Ihnen, Ihre Widerstandsfähigkeit zu stärken und das Vertrauen in die Wiederherstellungsfähigkeit zu bewahren - unabhängig davon, wie sich die Umgebung verändert.
Optimieren Sie Ihre Wiederherstellungsziele mit Datto BCDR
Die Optimierung von RTO und RPO ist eine wesentliche Voraussetzung für den Aufbau betrieblicher Resilienz und die Sicherstellung der Geschäftskontinuität bei Störungen. Um diese Ziele zu erreichen, bedarf es nicht nur der Planung, sondern auch der richtigen Technologie - und genau hier bietet Datto BCDR einen außergewöhnlichen Mehrwert.
Datto BCDR wurde entwickelt, um MSPs und IT-Teams dabei zu unterstützen, selbst die anspruchsvollsten Wiederherstellungsziele zu erreichen. Es automatisiert den Schutz, rationalisiert die Wiederherstellung und stellt sicher, dass Daten und Systeme jederzeit schnell und zuverlässig wiederhergestellt werden können.
Mit Datto BCDR können Sie Daten automatisch alle fünf Minuten sichern, um mögliche Datenverluste zu minimieren und die Wiederherstellungspunkte aktuell zu halten. Die speziell entwickelten Appliances dienen als lokale Wiederherstellungsziele, so dass Workloads und Anwendungen während eines Ausfalls direkt auf dem Gerät ausgeführt werden können. Wenn Systeme vor Ort beeinträchtigt werden, wird die Wiederherstellung sofort auf die unveränderliche Datto Cloud verlagert, was Virtualisierung und nahtlose Geschäftskontinuität ermöglicht.
Funktionen wie „1-Click Disaster Recovery“ (1-Click DR) sorgen für ein nahezu sofortiges Failover, sodass Systeme innerhalb weniger Minuten wieder online sind. Die unveränderliche Datto Cloud wurde speziell für Backup und Disaster Recovery entwickelt und bietet Sicherheit auf Unternehmensniveau, geografisch verteilte Datensicherung sowie kosteneffiziente Skalierbarkeit.
Jedes Backup wird außerdem automatisch durch eine Screenshot-Bestätigung und Service-Level-Checks verifiziert, was einen visuellen Beweis dafür liefert, dass jedes Backup bootfähig und für eine sofortige Wiederherstellung bereit ist. Mit diesen Funktionen können Unternehmen selbstbewusst aggressive RTO- und RPO-Ziele erreichen und gleichzeitig die vollständige Datenintegrität aufrechterhalten.
Erfahren Sie mehr über Datto BCDR und entdecken Sie, wie Sie damit Ihre Wiederherstellungsleistung optimieren und sich selbst oder Ihre Kunden vor Ausfallzeiten schützen können.




