Cómo optimizar el RTO y el RPO: 10 prácticas recomendadas
Cada minuto de inactividad cuenta. Para las empresas, la capacidad de recuperarse rápidamente puede determinar si un incidente se convierte en un contratiempo menor o en una crisis a gran escala. Es por eso que los objetivos de tiempo de recuperación (RTO) y los objetivos de punto de recuperación (RPO) son métricas esenciales para todo equipo de TI y MSP. Definen qué tan rápido deben restaurarse los sistemas y cuántos datos se pueden perder antes de que la empresa comience a sentir el impacto. Cuando se gestionan de manera efectiva, estos puntos de referencia ayudan a las organizaciones a prevenir la pérdida de datos críticos, minimizar las interrupciones operativas y desarrollar una resiliencia duradera frente a lo inesperado.
Para comprender los conceptos básicos de RTO y RPO y cómo influyen en la planificación de la continuidad de las operaciones, consulta nuestra guía completa: RTO y RPO: ¿Cuál es la diferencia y por qué son importantes?
En este artículo, iremos más allá de los conceptos básicos y nos centraremos en las 10 mejores prácticas para optimizar el RTO y el RPO. Estas estrategias prácticas ayudarán a las empresas y a los MSP a perfeccionar los objetivos de recuperación, reforzar la protección de datos y mantener un tiempo de actividad constante incluso cuando se produzca un desastre.
Antes de comenzar, tómate unos minutos para ver cuánto podrían costarte realmente a ti o a los negocios de tus clientes los tiempos de inactividad. Usa la Calculadora de tiempo de recuperación y costo de inactividad para estimar las pérdidas potenciales derivadas de interrupciones en el servicio o en los datos, y obtén información valiosa sobre cómo unos objetivos de recuperación optimizados pueden proteger directamente tus utilidades.
10 prácticas recomendadas para mejorar el RTO y el RPO
El objetivo de optimizar el RTO y el RPO es desarrollar una estrategia de continuidad y recuperación que proteja los datos críticos y mantenga las operaciones comerciales en funcionamiento incluso durante una interrupción. Veamos las 10 mejores prácticas que ayudan a las empresas y a los MSP a ajustar su RTO y RPO. Estas tácticas probadas muestran cómo convertir el RTO y el RPO de métricas teóricas en resultados medibles y alcanzables, y cómo las soluciones de BCDR como las de Datto facilitan mucho la puesta en práctica de estas tácticas.
1. Priorizar los datos y sistemas críticos
No todos los sistemas o conjuntos de datos merecen el mismo nivel de urgencia en cuanto a la recuperación. Para establecer objetivos de RTO y RPO realistas y eficaces, las organizaciones deben identificar primero qué cargas de trabajo son verdaderamente críticas para la misión.
Comience con un análisis de impacto en el negocio (BIA) para determinar qué aplicaciones, bases de datos y servicios tienen mayor impacto en las operaciones diarias. Algunos sistemas, como las plataformas de procesamiento financiero o las bases de datos de clientes, requieren un tiempo de inactividad casi nulo y una pérdida de datos mínima. Otros, como los informes internos o los registros archivados, pueden tolerar tiempos de recuperación más largos y copias de seguridad menos frecuentes.
Por ejemplo, el sistema de punto de venta (POS) de una cadena minorista podría requerir un RTO de 15 minutos y un RPO de cinco minutos para evitar la pérdida de transacciones. Por otro lado, su plataforma de análisis de marketing podría funcionar bien con un RTO de cuatro horas y un RPO de una hora.
La priorización garantiza que los recursos se concentren donde más importan, lo que permite a los equipos de TI y a los MSP equilibrar la resiliencia con la rentabilidad.
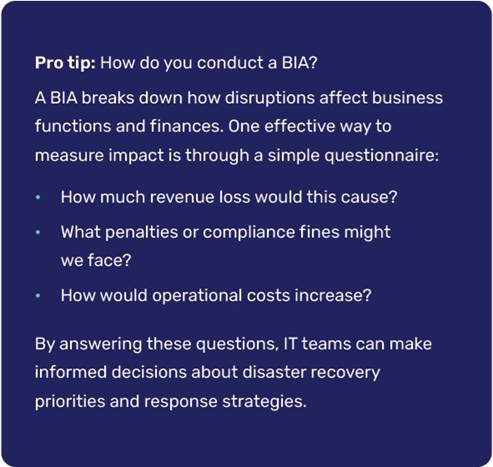
Fig. 1: Cómo realizar un BIA
2. Aumentar la frecuencia de las copias de seguridad
Las copias de seguridad frecuentes reducen el riesgo de pérdida de datos entre puntos de restauración. Cuanto más corto sea el intervalo entre copias de seguridad, menor será el impacto potencial de una falla del sistema.
Gracias a las modernas tecnologías de respaldo, las organizaciones pueden programar respaldos con una frecuencia de hasta cada cinco minutos, lo que garantiza que, incluso en caso de una interrupción inesperada, solo se pierda una cantidad mínima de datos. Este enfoque es especialmente valioso para entornos con un uso intensivo de datos, como el comercio electrónico o los sistemas financieros, donde incluso unos pocos minutos de información perdida pueden tener consecuencias reales para el negocio.
3. Replicar las copias de seguridad para garantizar la redundancia
Confiar en una única ubicación de respaldo deja sus datos en riesgo. La replicación de respaldos en múltiples entornos —locales, en la nube e híbridos— garantiza que los datos sigan siendo accesibles incluso si falla un sitio o un sistema. Este enfoque no solo reduce la pérdida de datos, sino que también acorta el tiempo de recuperación al proporcionar múltiples rutas de recuperación.
Estrategias para reforzar la redundancia:
- Adopta la regla de respaldo 3-2-1-1-0: mantén tres copias de tus datos, en dos soportes diferentes, con una almacenada fuera de las instalaciones, otra inmutable o fuera de línea y cero errores de respaldo verificados mediante pruebas. Obtén más información sobre la regla moderna de respaldo 3-2-1-1-0.
- Aprovecha la distribución geográfica: almacena las copias de seguridad en regiones físicas o en la nube distintas para protegerte contra interrupciones regionales o desastres naturales.
- Aprovecha la replicación híbrida: combina dispositivos locales para una recuperación rápida en el sitio con la replicación en la nube para garantizar la resiliencia a largo plazo.
La replicación genera una verdadera resiliencia, garantizando que ningún fallo, interrupción o incidente pueda comprometer su capacidad para recuperar datos de forma rápida y segura.
4. Utiliza copias de seguridad inmutables y externas
El ransomware moderno no solo ataca los sistemas de producción, sino que también ataca la infraestructura de copias de seguridad. Si esas copias de seguridad pueden modificarse o eliminarse, la recuperación se vuelve imposible. Las copias de seguridad inmutables evitan este riesgo al bloquear los datos de las copias de seguridad para que no puedan modificarse, sobrescribirse ni borrarse durante un período de retención definido.
La inmutabilidad se garantiza mediante una combinación de políticas definidas por software y las capacidades de la plataforma de almacenamiento. Estos controles aseguran que los datos permanezcan exactamente como estaban en el momento de la copia de seguridad, independientemente de errores de los usuarios, infecciones de malware o manipulaciones internas. Esto crea un punto de restauración limpio y verificable en todo momento, una protección esencial contra las amenazas cibernéticas modernas.
Para conocer más a fondo cómo la inmutabilidad refuerza la seguridad de las copias de seguridad, lee nuestra guía sobre copias de seguridad inmutables.
5. Automatizar los procesos de respaldo y recuperación
Los pasos manuales de respaldo y recuperación pueden ralentizar los tiempos de respuesta y provocar errores costosos. La automatización garantiza que todos los procesos, desde la captura de datos hasta la restauración completa del sistema, se realicen de forma rápida, coherente y según lo planeado. Al reducir la intervención manual, los equipos de TI y los MSP pueden mantener un rendimiento de recuperación confiable que se ajuste a los objetivos definidos de RTO y RPO.
Áreas clave en las que la automatización mejora la confiabilidad:
- Programación automatizada: garantiza que las copias de seguridad se realicen a intervalos precisos sin depender de activaciones manuales, lo que mantiene la protección de los datos de manera continua y predecible.
- Verificación automatizada: Valida la integridad de cada copia de seguridad mediante comprobaciones integradas o restauraciones de prueba, lo que garantiza que los puntos de recuperación sean utilizables cuando sea necesario.
- Conmutación automática en caso de falla: coordina la recuperación fluida del sistema hacia entornos de respaldo o la nube, lo que minimiza el tiempo de inactividad y garantiza que las operaciones se reanuden rápidamente.
Con estas capacidades, la automatización transforma la recuperación de un proceso reactivo en una rutina controlada y repetible que cumple los objetivos de recuperación en todo momento.
6. Supervisar, verificar y validar las copias de seguridad
Incluso las copias de seguridad más frecuentes pierden su valor si no se pueden restaurar. La supervisión y verificación continuas garantizan que las copias de seguridad se completen correctamente, permanezcan intactas y sean totalmente recuperables cuando sea necesario. La supervisión proactiva ayuda a detectar problemas —como tareas de copia de seguridad fallidas, replicaciones incompletas o archivos dañados— mucho antes de que pongan en peligro los objetivos de recuperación.
Esta práctica también se ajusta perfectamente a la estrategia de respaldo 3-2-1-1-0, en la que el «0» final representa cero errores de respaldo. Para lograr ese cero, se requiere una verificación automatizada rutinaria.
La verificación de copias de seguridad brinda a los equipos de TI y a los proveedores de servicios gestionados (MSP) plena confianza en su estrategia de protección de datos. Para descubrir cómo la verificación avanzada de copias de seguridad puede fortalecer la protección de tus datos, echa un vistazo a la verificación avanzada de copias de seguridad de Datto.
7. Aprovecha la virtualización para una recuperación inmediata
La virtualización ha revolucionado la recuperación ante desastres al permitir que los sistemas se pongan en marcha directamente desde las copias de seguridad. En lugar de esperar a que se reconstruyan los sistemas por completo o a que se realicen largas transferencias de datos, los equipos de TI pueden iniciar máquinas virtuales a partir de imágenes de copias de seguridad recientes en cuestión de minutos. Esta capacidad reduce drásticamente el tiempo de inactividad y ayuda a cumplir con objetivos de RTO exigentes.
Contar con la flexibilidad de virtualizar tanto localmente como en la nube garantiza una disponibilidad continua, independientemente de dónde se produzca una falla. La virtualización local permite la recuperación inmediata ante interrupciones en las instalaciones, mientras que la virtualización en la nube ofrece una red de seguridad externa en caso de que el sitio principal se vea comprometido. Juntas, crean un marco de recuperación sin interrupciones que mantiene las operaciones en funcionamiento mientras se completan las restauraciones completas en segundo plano.
8. Implementar la conmutación automática en caso de falla
Cuando se produce una interrupción del servicio, cada segundo cuenta. La conmutación automática por error elimina los retrasos de la intervención manual al transferir instantáneamente las operaciones a sistemas en espera o a una infraestructura secundaria. Esto garantiza que las aplicaciones críticas sigan estando disponibles, incluso si falla el entorno principal.
Mediante el uso de flujos de trabajo predefinidos y probados, la conmutación por error automatizada minimiza los errores humanos y ofrece un proceso de recuperación consistente que mantiene los servicios esenciales en línea. Ya sea a través de clústeres de conmutación por error o de la coordinación de la recuperación ante desastres basada en la nube, la automatización garantiza la continuidad sin interrupciones.
Para saber más sobre cómo la conmutación por error respalda la continuidad del negocio y la recuperación rápida, lee nuestro blog sobre qué es la conmutación por error y cómo funciona.
9. Realizar pruebas periódicas de recuperación ante desastres
Incluso el plan de recuperación más avanzado puede fallar si nunca se prueba. Las pruebas periódicas de recuperación ante desastres (DR) garantizan que sus copias de seguridad, flujos de trabajo de recuperación e infraestructura funcionen exactamente como se espera cuando ocurra un incidente real.
Las pruebas confirman que los objetivos de RTO y RPO son alcanzables en condiciones reales, al tiempo que revelan deficiencias en los procedimientos, las configuraciones o la documentación. Esto ayuda a los equipos a mantener la confianza, estar preparados y listos para responder rápidamente cuando se produce una interrupción.
Las pruebas planificadas y no planificadas —junto con las revisiones posteriores a las pruebas— permiten una mejora continua, lo que garantiza que los procesos de recuperación evolucionen al ritmo de los cambios en el negocio y la tecnología. Para obtener más información sobre los distintos escenarios y métodos de pruebas de recuperación ante desastres, consulta nuestra guía sobre pruebas de recuperación ante desastres.
10. Revisar y perfeccionar los planes de recuperación
La planificación de la recuperación no es una tarea que se realiza una sola vez; es un proceso continuo. A medida que su negocio crece y las tecnologías evolucionan, los objetivos de recuperación también deben evolucionar. Revisar periódicamente sus planes de recuperación ante desastres y de continuidad del negocio garantiza que sus objetivos de RTO y RPO sigan siendo realistas, relevantes y alcanzables.
Evalúe el desempeño de la recuperación después de cada prueba o incidente, y tenga en cuenta los nuevos sistemas, flujos de trabajo o requisitos de cumplimiento. Involucrar a las partes interesadas clave en estas revisiones mantiene las prioridades de recuperación alineadas con los objetivos comerciales.
El perfeccionamiento constante impulsa la mejora continua, lo que le ayuda a fortalecer la resiliencia y a mantener la confianza en la capacidad de recuperación, sin importar cómo cambie el entorno.
Optimice los objetivos de recuperación con Datto BCDR
Optimizar el RTO y el RPO es esencial para desarrollar la resiliencia operativa y garantizar la continuidad del negocio cuando se producen interrupciones. Alcanzar estos objetivos requiere no solo planificación, sino también la tecnología adecuada, y ahí es donde Datto BCDR ofrece un valor excepcional.
Datto BCDR está diseñado para ayudar a los MSP y a los equipos de TI a cumplir incluso los objetivos de recuperación más exigentes. Automatiza la protección, agiliza la recuperación y garantiza que los datos y los sistemas estén siempre listos para restaurarse de forma rápida y confiable.
Con Datto BCDR, puede realizar copias de seguridad de los datos automáticamente cada cinco minutos, lo que minimiza la posible pérdida de datos y mantiene actualizados los puntos de recuperación. Sus dispositivos diseñados específicamente para este fin funcionan también como destinos de recuperación locales, lo que permite que las cargas de trabajo y las aplicaciones se ejecuten directamente en el dispositivo durante una interrupción del servicio. Si los sistemas locales se ven comprometidos, la recuperación se traslada instantáneamente a la nube inmutable de Datto, lo que permite la virtualización y una continuidad del negocio sin interrupciones.
Funciones como la recuperación ante desastres con un solo clic (1-Click DR) hacen que la conmutación por error sea casi instantánea, lo que permite que los sistemas vuelvan a estar en línea en cuestión de minutos. La nube inmutable de Datto está diseñada específicamente para la copia de seguridad y la recuperación ante desastres, y ofrece seguridad de nivel empresarial, protección de datos geodistribuida y escalabilidad rentable.
Además, cada copia de seguridad se verifica automáticamente mediante capturas de pantalla y comprobaciones del nivel de servicio, lo que proporciona una prueba visual de que cada copia de seguridad es arrancable y está lista para una restauración inmediata. En conjunto, estas capacidades permiten a las organizaciones alcanzar con confianza objetivos ambiciosos de RTO y RPO, al tiempo que mantienen la integridad total de los datos.
Descubre más sobre Datto BCDR para ver cómo puede optimizar tu rendimiento de recuperación y protegerte a ti o a tus clientes contra el tiempo de inactividad.




