Comment optimiser le RTO et le RPO : 10 bonnes pratiques
Chaque minute de temps d'arrêt compte. Pour les entreprises, la capacité à récupérer rapidement peut déterminer si un incident devient un revers mineur ou une crise à grande échelle. C'est pourquoi les objectifs de temps de récupération (RTO) et de point de récupération (RPO) sont des mesures essentielles pour chaque équipe informatique et MSP. Ils définissent la vitesse à laquelle les systèmes doivent être restaurés et la quantité de données qui peuvent être perdues avant que l'entreprise ne commence à en ressentir l'impact. Lorsqu'ils sont gérés efficacement, ces repères aident les organisations à prévenir la perte de données critiques, à minimiser les perturbations opérationnelles et à construire une résilience durable contre les imprévus.
Pour comprendre les principes fondamentaux du RTO et du RPO, ainsi que leur influence sur la planification de la continuité d'activité, consultez notre guide complet : RTO et RPO : quelle est la différence et pourquoi sont-ils importants ?
Dans cet article, nous allons aller au-delà des bases et nous concentrer sur les 10 meilleures pratiques pour optimiser le RTO et le RPO. Ces stratégies pratiques aideront les entreprises et les MSP à affiner leurs objectifs de reprise, à renforcer la protection des données et à maintenir un temps de fonctionnement constant, même en cas de sinistre.
Avant de commencer, prenez quelques minutes pour évaluer ce que les temps d’arrêt pourraient réellement coûter à votre entreprise ou à celles de vos clients. Utilisez le calculateur de temps de reprise et de coût des temps d’arrêt pour estimer les pertes potentielles liées aux pannes ou aux perturbations des données, et découvrez comment des objectifs de reprise optimisés peuvent directement protéger vos résultats financiers.
10 bonnes pratiques pour améliorer le RTO et le RPO
L'objectif de l'optimisation du RTO et du RPO est de mettre en place une stratégie de continuité et de restauration qui protège les données critiques et maintient les activités de l'entreprise même en cas d'interruption. Voyons les 10 meilleures pratiques qui aident les entreprises et les MSP à affiner leur RTO et leur RPO. Ces tactiques éprouvées montrent comment transformer le RTO et le RPO de métriques théoriques en résultats mesurables et réalisables - et comment les solutions de BCDR comme celles de Datto facilitent grandement la mise en œuvre de ces tactiques.
1. Donner la priorité aux données et aux systèmes critiques
Chaque système ou ensemble de données ne mérite pas le même niveau d'urgence en matière de restauration. Pour fixer des objectifs RTO et RPO réalistes et efficaces, les entreprises doivent d'abord identifier les charges de travail réellement critiques.
Commencez par une analyse de l'impact sur l'entreprise (BIA) afin de déterminer les applications, les bases de données et les services qui ont le plus d'impact sur les opérations quotidiennes. Certains systèmes, tels que les plateformes de traitement financier ou les bases de données clients, nécessitent un temps d'arrêt proche de zéro et une perte de données minimale. D'autres, comme les rapports internes ou les archives, peuvent tolérer des temps de récupération plus longs et des sauvegardes moins fréquentes.
Par exemple, le système de point de vente (POS) d'une chaîne de magasins peut nécessiter un RTO de 15 minutes et un RPO de cinq minutes pour éviter les pertes de transactions. En revanche, sa plateforme d'analyse marketing pourrait fonctionner correctement avec un RTO de quatre heures et un RPO d'une heure.
La priorisation garantit que les ressources sont concentrées là où elles sont les plus importantes, ce qui permet aux équipes informatiques et aux MSP d'équilibrer la résilience et la rentabilité.
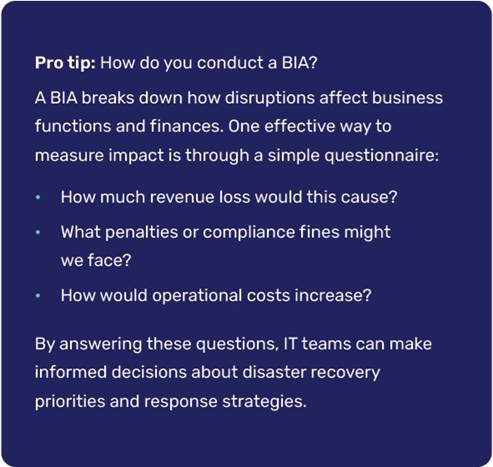
Fig 1 : Comment réaliser un BIA
2. Augmenter la fréquence des sauvegardes
Des sauvegardes fréquentes réduisent le risque de perte de données entre les points de restauration. Plus l'intervalle entre les sauvegardes est court, moins l'impact potentiel d'une défaillance du système est important.
Grâce aux technologies de sauvegarde modernes, les entreprises peuvent programmer des sauvegardes toutes les cinq minutes, ce qui garantit que même en cas de panne inattendue, seules des données minimales sont perdues. Cette approche est particulièrement précieuse pour les environnements à forte intensité de données tels que le commerce électronique ou les systèmes financiers, où même quelques minutes d'informations manquantes peuvent avoir de réelles conséquences pour l'entreprise.
3. Dupliquer les sauvegardes à des fins de redondance
S'appuyer sur un seul emplacement de sauvegarde rend vos données vulnérables. La réplication des sauvegardes dans plusieurs environnements - local, cloud et hybride - garantit que les données restent accessibles même en cas de défaillance d'un site ou d'un système. Cette approche permet non seulement de réduire les pertes de données, mais aussi de raccourcir les délais de récupération en offrant plusieurs voies de récupération.
Stratégies pour renforcer la redondance :
- Adoptez la règle de sauvegarde « 3-2-1-1-0 »: conservez trois copies de vos données, sur deux supports différents, dont une stockée hors site, une autre immuable ou hors ligne, et assurez-vous qu’aucune erreur de sauvegarde ne soit détectée lors des tests. Découvrez-en plus sur la règle moderne de sauvegarde « 3-2-1-1-0 ».
- Tirez parti de la répartition géographique: stockez vos sauvegardes dans des régions physiques ou cloud distinctes afin de vous prémunir contre les pannes régionales ou les catastrophes naturelles.
- Tirez parti de la réplication hybride: associez des appliances sur site pour une reprise locale rapide à une réplication dans le cloud pour une résilience à long terme.
La réplication crée une véritable résilience, garantissant qu'aucune défaillance, panne ou événement ne peut compromettre votre capacité à récupérer les données rapidement et en toute confiance.
4. Utilisez des sauvegardes immuables et hors site
Les ransomwares modernes ne ciblent pas seulement les systèmes de production, ils s'attaquent également à l'infrastructure de sauvegarde. Si ces sauvegardes peuvent être modifiées ou supprimées, la récupération devient impossible. Les sauvegardes immuables préviennent ce risque en verrouillant les données de sauvegarde afin qu'elles ne puissent pas être modifiées, écrasées ou effacées pendant une période de conservation définie.
L'immuabilité est assurée par une combinaison de politiques définies par logiciel et de capacités de la plate-forme de stockage. Ces contrôles garantissent que les données restent exactement telles qu'elles étaient au moment de la sauvegarde, indépendamment d'une erreur de l'utilisateur, d'une infection par un logiciel malveillant ou d'une altération par un initié. Cela crée un point de restauration propre et vérifiable à chaque fois - une protection essentielle contre les cyber-menaces modernes.
Pour en savoir plus sur la manière dont l'immuabilité renforce la sécurité des sauvegardes, consultez notre guide sur les sauvegardes immuables.
5. Automatiser les processus de sauvegarde et de restauration
Les étapes manuelles de sauvegarde et de restauration peuvent ralentir les temps de réponse et introduire des erreurs coûteuses. L'automatisation garantit que chaque processus - de la capture des données à la restauration complète du système - se déroule rapidement, de manière cohérente et conformément au plan. En réduisant les interventions manuelles, les équipes informatiques et les MSP peuvent maintenir une performance de restauration fiable qui s'aligne sur les objectifs RTO et RPO définis.
Domaines clés où l'automatisation améliore la fiabilité :
- Planification automatisée: garantit que les sauvegardes s'effectuent à des intervalles précis sans recourir à des déclenchements manuels, assurant ainsi une protection des données continue et prévisible.
- Vérification automatisée: vérifie l'intégrité de chaque sauvegarde à l'aide de contrôles intégrés ou de restaurations tests, garantissant ainsi que les points de restauration sont exploitables en cas de besoin.
- Basculement automatique: coordonne une reprise transparente du système vers des environnements de secours ou vers le cloud, ce qui réduit au minimum les temps d'arrêt et garantit une reprise rapide des opérations.
Grâce à ces capacités, l'automatisation transforme la récupération d'un processus réactif en une routine contrôlée et reproductible qui atteint les objectifs de récupération à chaque fois.
6. Surveiller, vérifier et valider les sauvegardes
Même les sauvegardes les plus fréquentes perdent de leur valeur si elles ne peuvent pas être restaurées. La surveillance et la vérification continues garantissent que les sauvegardes se terminent avec succès, qu'elles ne sont pas corrompues et qu'elles sont entièrement récupérables en cas de besoin. Une surveillance proactive permet de détecter les problèmes - tels que les échecs de sauvegarde, les réplications incomplètes ou les fichiers endommagés - bien avant qu'ils ne menacent les objectifs de restauration.
Cette pratique s'aligne étroitement sur la stratégie de sauvegarde 3-2-1-1-0, où le "0" final représente zéro erreur de sauvegarde. Pour atteindre ce zéro, il faut procéder à des vérifications automatisées de routine.
La vérification des sauvegardes permet aux équipes informatiques et aux prestataires de services gérés (MSP) d'avoir pleinement confiance dans leur stratégie de protection des données. Pour découvrir comment une vérification avancée des sauvegardes peut renforcer la protection de vos données, consultez la solution de vérification avancée des sauvegardes proposée par Datto.
7. Tirer parti de la virtualisation pour une reprise immédiate
La virtualisation a révolutionné la reprise après sinistre en permettant de lancer des systèmes directement à partir de sauvegardes. Au lieu d'attendre la reconstruction complète du système ou de longs transferts de données, les équipes informatiques peuvent lancer des machines virtuelles à partir d'images de sauvegarde récentes en quelques minutes. Cette capacité réduit considérablement les temps d'arrêt et permet d'atteindre des objectifs de RTO ambitieux.
Avoir la flexibilité de virtualiser à la fois localement et dans le nuage garantit une disponibilité continue, quel que soit l'endroit où se produit une défaillance. La virtualisation locale permet une reprise immédiate en cas d'interruption sur site, tandis que la virtualisation dans le nuage offre un filet de sécurité hors site si le site principal est compromis. Ensemble, elles créent un cadre de reprise transparent qui maintient les opérations en cours pendant que des restaurations complètes sont effectuées en arrière-plan.
8. Mettre en place un basculement automatique
En cas de panne, chaque seconde compte. Le basculement automatisé élimine les délais d'intervention manuelle en transférant instantanément les opérations vers des systèmes de secours ou une infrastructure secondaire. Les applications critiques restent ainsi disponibles, même en cas de défaillance de l'environnement principal.
En utilisant des flux de travail prédéfinis et testés, le basculement automatisé minimise l'erreur humaine et fournit un processus de récupération cohérent qui maintient les services essentiels en ligne. Qu'il s'agisse d'un clustering de basculement ou d'une orchestration de reprise après sinistre basée sur le cloud, l'automatisation garantit une continuité sans interruption.
Pour en savoir plus sur la manière dont le basculement contribue à la continuité des activités et à une reprise rapide, consultez notre article de blog expliquant ce qu'est le basculement et comment il fonctionne.
9. Effectuer régulièrement des tests de reprise après sinistre
Même le plan de reprise le plus avancé peut échouer s'il n'est jamais testé. Des tests réguliers de reprise après sinistre (DR) garantissent que vos sauvegardes, vos flux de travail de reprise et votre infrastructure fonctionnent exactement comme prévu lorsqu'un incident réel se produit.
Les tests permettent de valider que les objectifs de RTO et de RPO sont réalisables dans des conditions réelles, tout en révélant des lacunes dans les procédures, les configurations ou la documentation. Il aide les équipes à rester confiantes, préparées et prêtes à réagir rapidement en cas de perturbation.
Les tests planifiés et imprévus, associés à des analyses a posteriori, permettent une amélioration continue et garantissent que les processus de reprise après sinistre évoluent au rythme des changements opérationnels et technologiques. Pour en savoir plus sur les différents scénarios et méthodes de test de reprise après sinistre, consultez notre guide consacré aux tests de reprise après sinistre.
10. Examiner et affiner les plans de reprise
La planification de la reprise d'activité n'est pas un exercice ponctuel, c'est un processus continu. Au fur et à mesure que votre entreprise se développe et que les technologies évoluent, les objectifs de reprise d'activité doivent également évoluer. En révisant régulièrement vos plans de reprise après sinistre et de continuité des activités, vous vous assurez que vos objectifs de RTO et de RPO restent réalistes, pertinents et réalisables.
Évaluez les performances de restauration après chaque test ou incident, et prenez en compte les nouveaux systèmes, les flux de travail ou les exigences de conformité. L'implication des principales parties prenantes dans ces évaluations permet d'aligner les priorités de reprise sur les objectifs de l'entreprise.
L'affinage permanent permet une amélioration continue, ce qui vous aide à renforcer la résilience et à maintenir la confiance dans la capacité de récupération, quelle que soit l'évolution de l'environnement.
Optimiser les objectifs de récupération avec Datto BCDR
L'optimisation du RTO et du RPO est essentielle pour renforcer la résilience opérationnelle et assurer la continuité de l'activité en cas de perturbations. Pour atteindre ces objectifs, il faut non seulement planifier, mais aussi disposer de la bonne technologie - et c'est là que Datto BCDR offre une valeur exceptionnelle.
Datto BCDR est conçu pour aider les MSP et les équipes informatiques à atteindre les objectifs de restauration les plus exigeants. Il automatise la protection, rationalise la restauration et garantit que les données et les systèmes sont toujours prêts à être restaurés rapidement et de manière fiable.
Avec Datto BCDR, vous pouvez sauvegarder automatiquement des données aussi fréquemment que toutes les cinq minutes, en minimisant les pertes de données potentielles et en gardant les points de récupération à jour. Ses appliances conçues à cet effet servent également de cibles de restauration locales, ce qui permet aux charges de travail et aux applications de s'exécuter directement sur l'appareil pendant une panne. Si les systèmes sur site sont compromis, la restauration bascule instantanément vers le Cloud Datto immuable, permettant la virtualisation et une continuité d'activité sans faille.
Des fonctionnalités telles que la reprise après sinistre en un clic (1-Click DR) permettent un basculement quasi instantané, remettant les systèmes en ligne en quelques minutes. Le cloud immuable de Datto est spécialement conçu pour la sauvegarde et la reprise après sinistre ; il offre une sécurité de niveau entreprise, une protection des données géodistribuée et une évolutivité économique.
Chaque sauvegarde est également vérifiée automatiquement par le biais d'une confirmation de capture d'écran et de contrôles de niveau de service, fournissant une preuve visuelle que chaque sauvegarde est amorçable et prête à être restaurée immédiatement. L'ensemble de ces fonctionnalités permet aux entreprises d'atteindre en toute confiance des objectifs ambitieux en matière de RTO et de RPO, tout en conservant une intégrité totale des données.
Découvrez-en davantage sur la solution BCDR de Datto pour comprendre comment elle peut optimiser vos performances de reprise après sinistre et vous protéger, vous ou vos clients, contre les temps d'arrêt.




