Wat is downtime? Impact, kosten en hoe het te verminderen
De verwachtingen van klanten zijn veranderd. Vandaag de dag verwachten mensen onmiddellijke toegang tot digitale diensten - altijd en overal. Als een bedrijf offline gaat, zelfs kortstondig, riskeert het het vertrouwen van klanten, inkomsten en productiviteit te verliezen. Daarom is downtime een belangrijke existentiële bedreiging geworden voor bedrijven, vooral voor het midden- en kleinbedrijf (MKB). Zelfs een storing van een paar uur kan langdurige schade aanrichten.
Intussen komen bedreigingen zoals cyberaanvallen, hardwarestoringen en systeemuitval steeds vaker voor, waardoor het voor bedrijven een grotere uitdaging dan ooit is om de operationele continuïteit te handhaven. In dit artikel leggen we uit wat downtime echt betekent voor bedrijven en waarom het gebeurt. We onderzoeken ook de financiële en reputatietol die het kan eisen en hoe je de impact ervan kunt beperken door strategische bedrijfscontinuïteits- en noodherstelplanning (BCDR).
Wat is uitvaltijd?
Downtime verwijst naar elke periode waarin systemen, applicaties of netwerken niet beschikbaar zijn of niet presteren zoals verwacht. Deze onderbreking kan invloed hebben op interne activiteiten, klantinteracties of beide. Zelfs een paar seconden downtime kan de productiviteit, omzet en gebruikerservaring beïnvloeden.
Downtime kan gepland zijn, zoals gepland onderhoud, of ongepland door problemen zoals hardwarestoringen, softwarefouten of cyberaanvallen. Hoewel bedrijven streven naar maximale uptime, is incidentele downtime onvermijdelijk. De sleutel is hoe snel en effectief een bedrijf kan reageren en herstellen van tegenslagen.
Soorten uitvaltijd
Downtime valt uiteen in twee hoofdcategorieën: gepland en ongepland. Hoewel beide de normale werking onderbreken, verschillen ze in hoe ze optreden en hoe bedrijven kunnen reageren. Inzicht in het onderscheid helpt organisaties zich voor te bereiden op routinematige verstoringen en snel te reageren op onverwachte verstoringen.
Geplande uitvaltijd
Geplande downtime wordt van tevoren ingepland om essentiële taken uit te voeren, zoals onderhoud, upgrades of patches. Omdat het gepland is, kunnen bedrijven bepalen wanneer en hoe het gebeurt - meestal tijdens daluren - om de impact op de productiviteit en de gebruikerservaring te beperken.
Veel voorkomende redenen voor geplande downtime zijn
- Systeemupgrades
- Routinematig onderhoud
- Infrastructuurwijzigingen of gegevensmigratie
- Beveiliging patchen
Met de juiste planning en communicatie kan geplande downtime worden beheerd met minimale verstoring.
Ongeplande uitvaltijd
Ongeplande uitval gebeurt zonder waarschuwing en is vaak het gevolg van onverwachte storingen, externe gebeurtenissen of cyberincidenten. Deze uitval is meestal verstorender en moeilijker te beheren, vooral als er geen herstelplan aanwezig is.
Voorbeelden van ongeplande stilstand zijn:
- Hardware storingen
- Software bugs of crashes
- Stroomuitval
- Extreme weersomstandigheden zoals bosbranden, overstromingen en orkanen
- Cyberaanvallen zoals ransomware
Ongeplande downtime kan leiden tot operationele verlamming, gederfde inkomsten en schade aan het vertrouwen van de klant, vooral als het herstel wordt vertraagd.
Belangrijkste oorzaken van downtime
Ongeplande downtime kan zonder waarschuwing toeslaan en bedrijfsactiviteiten op elke schaal verstoren. Inzicht in de meest voorkomende oorzaken is cruciaal voor zowel preventie als sneller herstel. Van technische problemen tot natuurverschijnselen, weten waar kwetsbaarheden liggen helpt bedrijven hun verdediging te versterken en uptime te behouden.
Hardware- en softwarefouten
Servers, opslagsystemen en netwerkapparaten kunnen uitvallen door ouderdom, overbelasting of slechte configuratie. Softwareproblemen - zoals mislukte updates of incompatibele applicaties - kunnen ook systemen laten crashen of gegevens beschadigen. Zonder systeemredundantie of -bewaking kan zelfs een kleine storing de kerndiensten offline halen.
Stroomuitval
Stroomuitval, of dit nu te wijten is aan problemen met het lokale elektriciteitsnet of aan noodweer, kan de activiteiten onmiddellijk stilleggen. Bedrijven die vertrouwen op de infrastructuur op locatie zijn bijzonder kwetsbaar voor stroomuitval. Back-up stroomoplossingen en cloud-gebaseerde systemen kunnen helpen om toegang te behouden wanneer de lichten uitgaan.
Cyberaanvallen
Aanvallen zoals ransomware en DDoS (Distributed Denial-of-Service) kunnen systemen blokkeren, gegevens beschadigen en bedrijven uren of zelfs dagen offline houden. Naarmate cyberbedreigingen in omvang en frequentie toenemen, zijn zelfs kleine bedrijven steeds vaker het doelwit, waardoor beveiliging en herstelplanning van cruciaal belang zijn.
Menselijke fout
Simpele fouten hebben vaak grote gevolgen. Het per ongeluk verwijderen van bestanden, verkeerd geconfigureerde systemen of slecht beheerde updates kunnen leiden tot uitval. Regelmatige training en strikte protocollen voor wijzigingsbeheer kunnen deze risico's aanzienlijk beperken.
Natuurrampen
Gebeurtenissen zoals overstromingen, branden of orkanen kunnen de fysieke infrastructuur beschadigen en lange downtime veroorzaken. Bedrijven hebben cloudback-ups, off-site herstelsystemen en rampherstelplannen nodig om de continuïteit te waarborgen bij grootschalige verstoringen.
Wat is de impact van downtime op een bedrijf?
Downtime heeft gevolgen voor meer dan alleen IT-systemen. Van omzetverlies tot het niet halen van compliancedoelstellingen, het verstoort de dagelijkse activiteiten, schaadt de klantervaring en kan blijvende schade veroorzaken in het hele bedrijf. De belangrijkste punten van zorg zijn:
- Productiviteitsverlies en omzetderving: wanneer systemen uitvallen, komt het werk tot stilstand. Medewerkers hebben geen toegang tot hun tools, klanten kunnen geen aankopen doen en serviceteams staan voor een grote uitdaging. Of het nu gaat om een storing bij het afrekenen in een webwinkel of een stilgelegde productielijn: elke minuut dat het systeem offline is, kan leiden tot omzetderving en tijdverspilling.
- Schade aan de reputatie: Klanten verwachten snelle, betrouwbare dienstverlening. Regelmatige of langdurige storingen kunnen het vertrouwen snel ondermijnen en klanten ertoe aanzetten om over te stappen naar concurrenten. Het herstellen van de reputatie na een openbare dienstonderbreking kan tijd kosten — en gaat vaak gepaard met hoge kosten.
- Niet-naleving van SLA’s en regelgeving: Veel bedrijven werken op basis van service level agreements (SLA’s) die een constante beschikbaarheid en betrouwbaarheid vereisen. Uitval kan leiden tot schendingen van de SLA, financiële sancties of het verlies van contracten. In gereguleerde sectoren kan dit ook de naleving van de regelgeving in gevaar brengen, waardoor het bedrijf blootgesteld wordt aan boetes of juridische gevolgen.
De kosten van uitvaltijd
Downtime heeft een hoge prijs - niet alleen in verloren inkomsten, maar ook in productiviteit, herstelinspanningen en reputatieschade op lange termijn. Deze directe en indirecte kosten kunnen snel oplopen, vooral voor bedrijven die afhankelijk zijn van een constante systeembeschikbaarheid. Het kwantificeren van deze risico's helpt bedrijfsleiders geïnformeerde beslissingen te nemen over het investeren in preventie- en hersteloplossingen.
Hoe de kosten van downtime berekenen
Een eenvoudige manier om de financiële impact van downtime in te schatten is:
Downtimekosten = (Verloren inkomsten + productiviteitsverlies + herstelkosten + immateriële kosten) × uitvalduur
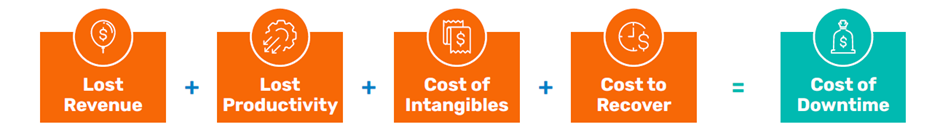
Fig 1: Kosten van downtime voor bedrijven
Elk onderdeel van deze formule speelt een rol:
- Gederfde inkomsten: gemiste verkopen of transacties tijdens de periode waarin het systeem buiten werking was.
- Productiviteitsverlies: Lonen die aan werknemers worden uitbetaald tijdens stilstand als gevolg van systeemstoringen.
- Herstelkosten: Uitgaven in verband met noodreparaties, IT-ondersteuning en overwerk.
- Immateriële kosten: imagoschade, klantverloop en gemiste toekomstige kansen.
Het kostenprofiel van elke organisatie is anders, maar rapporten uit de sector tonen aan dat downtime het MKB duizenden tot miljoenen dollars per dag kan kosten, afhankelijk van de grootte, de sector en de afhankelijkheid van het systeem.
Om inzicht te krijgen in de mogelijke gevolgen van uitval voor uw bedrijf of dat van uw klant, kunt u de cijfers eens doorrekenen met de calculator voor hersteltijd en uitvalkosten. Een duidelijk beeld van de financiële gevolgen maakt het gemakkelijker om prioriteit te geven aan bedrijfscontinuïteitsplanning.
Hoe downtime verminderen
Het minimaliseren van downtime komt neer op het inbouwen van veerkracht in elke laag van uw infrastructuur. Van preventief onderhoud tot snel herstel, een proactieve aanpak zorgt ervoor dat uw bedrijf blijft draaien, zelfs wanneer er storingen optreden. Hieronder staan essentiële strategieën die elke organisatie zou moeten toepassen om het risico en de impact van downtime te verminderen.
Overbodigheid en failover-systemen implementeren
Redundantie is de eerste verdedigingslinie tegen systeemuitval. Door kritieke componenten te dupliceren - zoals servers, opslagapparaten of netwerkpaden - zorgen bedrijven ervoor dat de activiteiten door kunnen gaan, zelfs als een primair systeem uitvalt. Failover-oplossingen gaan nog een stap verder door automatisch over te schakelen naar back-upsystemen wanneer er problemen worden gedetecteerd.
Als bijvoorbeeld een primaire server crasht, leidt een failover-systeem de activiteiten onmiddellijk om naar een secundaire server zonder dat handmatige tussenkomst vereist is. Cloudgebaseerde failover-systemen zijn bijzonder effectief en bieden schaalbare back-upomgevingen die zorgen voor een ononderbroken servicecontinuïteit.
Regelmatig back-ups maken en de herstelbaarheid controleren
Back-ups zijn essentieel, maar hun echte waarde ligt in hoe snel en betrouwbaar ze kunnen worden hersteld. Bedrijven moeten geautomatiseerde back-ups plannen van alle kritieke gegevens en applicaties, idealiter dagelijks of zelfs elk uur, afhankelijk van hun operationele behoeften. Deze back-ups moeten zowel on-site als off-site worden opgeslagen om bescherming te bieden tegen lokale storingen of rampen.
Net zo belangrijk is het controleren of de gegevens daadwerkelijk kunnen worden hersteld. Test uw back-ups regelmatig om er zeker van te zijn dat de gegevens binnen een aanvaardbare termijn kunnen worden hersteld. Zo weet u zeker dat u in geval van een storing de werkzaamheden kunt hervatten zonder noemenswaardig gegevensverlies of uitval.
Maak gebruik van geautomatiseerde, realtime bewaking
Real-time monitoringsystemen helpen problemen te detecteren voordat ze escaleren. Geautomatiseerde monitoringtools volgen de systeemprestaties, het resourcegebruik en afwijkingen in de infrastructuur. Wanneer een potentieel probleem wordt geïdentificeerd - zoals abnormaal CPU-gebruik of een falende schijf - worden waarschuwingen geactiveerd, zodat IT-teams snel kunnen handelen.
Real-time inzicht in uw omgeving vermindert de kans dat u wordt verrast door systeemstoringen of prestatieproblemen. Met voorspellende analyses kunnen sommige monitoringplatforms zelfs problemen signaleren voordat ze de werking beïnvloeden.
Regelmatig systeemonderhoud en updates uitvoeren
Systemen degraderen na verloop van tijd en verouderde software of hardware brengt risico's met zich mee. Regelmatig onderhoud zorgt ervoor dat de infrastructuur gezond en veilig blijft. Dit omvat het toepassen van beveiligingspatches, firmware-updates en software-upgrades om kwetsbaarheden aan te pakken en compatibiliteit te behouden.
Preventief onderhoud helpt ook bij het detecteren van tekenen van slijtage, systeemfouten of falende componenten. Door deze problemen proactief op te lossen, kunnen bedrijven plotselinge onderbrekingen voorkomen en de algehele betrouwbaarheid verbeteren.
Train medewerkers om menselijke fouten te minimaliseren
Menselijke fouten blijven een van de meest voorkomende - en vermijdbare - oorzaken van downtime. Fouten, zoals het verkeerd configureren van netwerkinstellingen, het verwijderen van kritieke bestanden of het verkeerd toepassen van updates, kunnen systemen onverwacht platleggen.
Om dit risico te beperken, moeten bedrijven zorgen voor voortdurende training voor alle werknemers, met name voor degenen die verantwoordelijk zijn voor het beheer van IT-systemen en netwerken. Duidelijke documentatie, toegangscontroles en gestandaardiseerde processen helpen bij het creëren van een gestructureerde omgeving waar fouten minder snel voorkomen. Regelmatige opfriscursussen en training op basis van scenario's kunnen het bewustzijn verder versterken.
Een uitgebreide BCDR-strategie ontwikkelen
Zelfs met strenge preventieve maatregelen zijn bepaalde verstoringen onvermijdelijk. Juist dan is een strategie voor bedrijfscontinuïteit en noodherstel (BCDR) van cruciaal belang. Een goed opgesteld BCDR-plan beschrijft hoe het bedrijf op verstoringen zal reageren en hoe snel de bedrijfsvoering kan worden hersteld.
Dit plan moet de bedrijfskritische systemen in kaart brengen, duidelijke hersteldoelstellingen (RTO/RPO) vaststellen en rollen en verantwoordelijkheden toewijzen tijdens een crisis. Het moet ook gedetailleerde communicatieprocedures bevatten om interne teams, klanten en partners tijdens incidenten op de hoogte te houden.
Door BCDR in te bedden in uw bedrijfsactiviteiten, kunt u de downtime beperken en met vertrouwen herstellen wanneer verstoringen toeslaan.
Minimaliseer downtime met Datto BCDR
Downtime kan onvermijdelijk zijn, maar hoe snel een bedrijf herstelt, heeft het zelf in de hand. De juiste tools en planning maken het verschil tussen urenlange onderbreking en een snel, naadloos herstel.
Datto BCDR is speciaal gebouwd om MSP's en IT-teams te helpen veerkrachtig te blijven tegen downtime. Het combineert geautomatiseerde back-up, directe failover en ingebouwde verificatie om downtime te verminderen en bedrijfsactiviteiten draaiende te houden, ongeacht wat er op hun pad komt.
Dit is hoe Datto BCDR bedrijven helpt uptime en continuïteit te behouden:
- Geautomatiseerde back-ups: Datto maakt om de vijf minuten een back-up van de gegevens, zodat u altijd over een recent herstelpunt beschikt en het risico op gegevensverlies tot een minimum wordt beperkt.
- Onmiddellijke virtualisatie, lokaal of in de cloud: als systemen uitvallen, kan Datto ze onmiddellijk virtualiseren — ter plaatse, in de cloud of beide — zodat de bedrijfsvoering binnen enkele minuten kan worden hervat.
- Geautomatiseerde controle van back-ups: Elke back-up wordt automatisch getest om te controleren of het systeem er succesvol mee opstart en of de applicaties en diensten naar behoren functioneren.
- Flexibele herstelopties: of u nu één bestand, een map of een volledige omgeving wilt herstellen, met Datto hebt u volledige controle over hoe u dit doet.
Met Datto BCDR zijn bedrijven niet alleen voorbereid op uitval; ze zijn ook in staat om snel te herstellen en hun bedrijfsvoering zonder onderbrekingen soepel te laten verlopen. Ontdek Datto BCDR en zie hoe het bedrijven te allen tijde cyberbestendig houdt.




