O que é tempo de inatividade? Impacto, custos e como reduzi-lo
As expectativas dos clientes mudaram. Hoje, as pessoas esperam acesso instantâneo a serviços digitais - a qualquer hora, em qualquer lugar. Se uma empresa ficar off-line, mesmo que brevemente, ela corre o risco de perder a confiança do cliente, a receita e a produtividade. É por isso que o tempo de inatividade se tornou uma ameaça existencial significativa para as empresas, especialmente as pequenas e médias empresas (SMBs). Mesmo algumas horas de interrupção podem causar danos duradouros a elas.
Enquanto isso, ameaças como ataques cibernéticos, falhas de hardware e interrupções do sistema tornaram-se cada vez mais comuns, fazendo com que seja mais desafiador do que nunca para as empresas manterem a continuidade operacional. Neste artigo, explicaremos o que o tempo de inatividade realmente significa para as empresas e por que ele acontece. Também examinaremos o impacto financeiro e na reputação que ele pode causar e como atenuar esse impacto por meio do planejamento estratégico de continuidade dos negócios e recuperação de desastres (BCDR).
O que é tempo de inatividade?
O tempo de inatividade refere-se a qualquer período em que os sistemas, aplicativos ou redes não estão disponíveis ou não funcionam como esperado. Essa interrupção pode afetar as operações internas, as interações com o cliente ou ambos. Mesmo alguns segundos de tempo de inatividade podem afetar a produtividade, a receita e a experiência do usuário.
O tempo de inatividade pode ser planejado, como a manutenção programada, ou não planejado devido a problemas como falhas de hardware, erros de software ou ataques cibernéticos. Embora as empresas busquem o máximo de tempo de atividade, o tempo de inatividade ocasional é inevitável. A chave é a rapidez e a eficácia com que uma empresa pode responder e se recuperar da adversidade.
Tipos de tempo de inatividade
O tempo de inatividade se divide em duas categorias principais: planejado e não planejado. Embora ambas interrompam as operações normais, elas diferem na forma como ocorrem e como as empresas podem reagir. Compreender a distinção ajuda as organizações a se prepararem para interrupções rotineiras e a responderem rapidamente às inesperadas.
Tempo de inatividade planejado
O tempo de inatividade planejado é programado com antecedência para executar tarefas essenciais, como manutenção, atualizações ou aplicação de patches. Como é antecipado, as empresas podem controlar quando e como ele ocorre - geralmente em horários fora de pico - para reduzir seu impacto sobre a produtividade e a experiência do usuário.
Os motivos comuns para o tempo de inatividade planejado incluem:
- Atualizações do sistema
- Manutenção de rotina
- Mudanças na infraestrutura ou migração de dados
- Aplicação de patches de segurança
Com planejamento e comunicação adequados, o tempo de inatividade planejado pode ser gerenciado com o mínimo de interrupção.
Tempo de inatividade não planejado
O tempo de inatividade não planejado acontece sem aviso e geralmente é o resultado de falhas inesperadas, eventos externos ou incidentes cibernéticos. Essas interrupções são normalmente mais perturbadoras e difíceis de gerenciar, especialmente se não houver um plano de recuperação em vigor.
Exemplos de tempo de inatividade não planejado incluem:
- Falhas de hardware
- Bugs ou falhas no software
- Quedas de energia
- Eventos climáticos extremos, como incêndios florestais, enchentes e furacões
- Ataques cibernéticos como ransomware
O tempo de inatividade não planejado pode levar à paralisação operacional, perda de receita e danos à confiança do cliente, especialmente se a recuperação for atrasada.
Principais causas do tempo de inatividade
O tempo de inatividade não planejado pode ocorrer sem aviso e interromper as operações comerciais em qualquer escala. Entender as causas mais comuns é crucial tanto para a prevenção quanto para uma recuperação mais rápida. De problemas técnicos a eventos naturais, saber onde estão as vulnerabilidades ajuda as empresas a fortalecer suas defesas e manter o tempo de atividade.
Falha de hardware e software
Servidores, sistemas de armazenamento e dispositivos de rede podem falhar devido à idade, sobrecarga ou configuração inadequada. Problemas de software - como falhas de atualização ou aplicativos incompatíveis - também podem travar sistemas ou corromper dados. Sem redundância de sistema ou monitoramento, até mesmo uma pequena falha pode colocar os serviços principais off-line.
Quedas de energia
A perda de energia, seja devido a problemas na rede local ou a condições climáticas severas, pode interromper instantaneamente as operações. As empresas que dependem de infraestrutura local são especialmente vulneráveis a quedas de energia. As soluções de energia de backup e os sistemas baseados em nuvem podem ajudar a manter o acesso quando as luzes se apagam.
Ataques cibernéticos
Ataques como ransomware e negação de serviço distribuída (DDoS) podem bloquear sistemas, corromper dados e manter as empresas off-line por horas ou até dias. À medida que as ameaças cibernéticas crescem em escala e frequência, até mesmo as pequenas empresas são cada vez mais visadas, o que torna crítico o planejamento de segurança e recuperação.
Erro humano
Erros simples muitas vezes têm grandes conseqüências. Exclusões acidentais de arquivos, sistemas mal configurados ou atualizações mal gerenciadas podem provocar interrupções. O treinamento regular e os protocolos rigorosos de gerenciamento de mudanças podem reduzir significativamente esses riscos.
Desastres naturais
Eventos como enchentes, incêndios ou furacões podem danificar a infraestrutura física e forçar um tempo de inatividade prolongado. As empresas precisam de backups na nuvem, sistemas de recuperação fora do local e planos de recuperação de desastres para garantir a continuidade diante de uma interrupção em grande escala.
Como o tempo de inatividade afeta uma empresa?
O tempo de inatividade afeta mais do que apenas os sistemas de TI. De vendas perdidas a metas de conformidade não cumpridas, ele interrompe as operações diárias, prejudica a experiência do cliente e pode criar danos duradouros em toda a empresa. As principais preocupações incluem:
- Perda de produtividade e receita: Quando os sistemas ficam fora do ar, o trabalho é interrompido. Os funcionários não conseguem acessar as ferramentas, os clientes não conseguem fazer compras e as equipes de atendimento ficam em apuros. Seja uma falha no processo de checkout de um site de comércio eletrônico ou uma linha de produção paralisada, cada minuto fora do ar pode significar perda de receita e tempo desperdiçado.
- Prejuízo à reputação: os clientes esperam um serviço rápido e confiável. Interrupções frequentes ou prolongadas podem minar rapidamente a confiança e levar os clientes a migrar para a concorrência. Reconstruir a reputação após uma interrupção no serviço público pode levar tempo — e, muitas vezes, acarreta um custo elevado.
- Incumprimento dos SLAs e da conformidade: Muitas empresas operam sob acordos de nível de serviço (SLAs) que exigem disponibilidade e confiabilidade consistentes. O tempo de inatividade pode levar a violações dos SLAs, penalidades financeiras ou perda de contratos. Em setores regulamentados, isso também pode colocar a conformidade em risco, expondo a empresa a multas ou consequências legais.
O custo do tempo de inatividade
O tempo de inatividade tem um preço alto - não apenas em perda de receita, mas em produtividade, esforços de recuperação e danos à reputação a longo prazo. Esses custos diretos e indiretos podem se acumular rapidamente, especialmente para empresas que dependem da disponibilidade constante do sistema. A quantificação desses riscos ajuda os líderes empresariais a tomar decisões informadas sobre o investimento em soluções de prevenção e recuperação.
Como calcular o custo do tempo de inatividade
Uma maneira simples de estimar o impacto financeiro do tempo de inatividade é:
Custo do tempo de inatividade = (receita perdida + produtividade perdida + custos de recuperação + custos intangíveis) × duração da interrupção
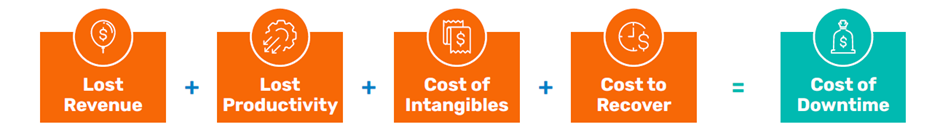
Fig. 1: Custo do tempo de inatividade para as empresas
Cada parte dessa fórmula desempenha um papel:
- Receita perdida: vendas ou transações perdidas durante o período de interrupção do serviço.
- Perda de produtividade: salários pagos aos funcionários durante o tempo ocioso em que os sistemas estão fora de serviço.
- Custos de recuperação: Despesas relacionadas a reparos de emergência, suporte de TI e horas extras.
- Custos intangíveis: danos à marca, perda de clientes e oportunidades futuras perdidas.
O perfil de custo de cada organização é diferente, mas os relatórios do setor mostram que o tempo de inatividade pode custar às PMEs de milhares a milhões de dólares por dia, dependendo do tamanho, do setor e da dependência do sistema.
Para entender como o tempo de inatividade pode afetar sua empresa ou a empresa do seu cliente, experimente fazer as contas com a Calculadora de Tempo de Recuperação e Custo de Inatividade. Uma visão clara do impacto financeiro facilita a definição de prioridades no planejamento da continuidade dos negócios.
Como reduzir o tempo de inatividade
Minimizar o tempo de inatividade se resume a criar resiliência em cada camada de sua infraestrutura. Da manutenção preventiva à recuperação rápida, uma abordagem proativa garante que sua empresa permaneça em funcionamento, mesmo quando ocorrem interrupções. Abaixo estão as estratégias essenciais que toda organização deve adotar para reduzir o risco e o impacto do tempo de inatividade.
Implementar sistemas de redundância e failover
A redundância é a primeira linha de defesa contra falhas no sistema. Ao duplicar componentes críticos - como servidores, dispositivos de armazenamento ou caminhos de rede - as empresas garantem que as operações possam continuar mesmo que um sistema primário falhe. As soluções de failover levam isso mais longe, alternando automaticamente as operações para sistemas de backup quando são detectados problemas.
Por exemplo, se um servidor primário falhar, um sistema de failover redireciona imediatamente as operações para um servidor secundário sem exigir intervenção manual. Os sistemas de failover baseados em nuvem são particularmente eficazes, fornecendo ambientes de backup escaláveis que garantem a continuidade ininterrupta do serviço.
Realizar backups frequentes e verificar a capacidade de recuperação
Os backups são essenciais, mas seu verdadeiro valor está na rapidez e na confiabilidade com que podem ser restaurados. As empresas devem programar backups automatizados de todos os dados e aplicativos críticos, de preferência diariamente ou até mesmo de hora em hora, dependendo de suas necessidades operacionais. Esses backups devem ser armazenados no local e fora dele para proteger contra falhas locais ou desastres.
Igualmente importante é verificar a capacidade de recuperação. Teste regularmente seus backups para garantir que os dados possam ser restaurados dentro de prazos aceitáveis. Isso garante que, em caso de falha, você possa retomar as operações sem perda significativa de dados ou tempo de inatividade.
Aproveite o monitoramento automatizado e em tempo real
Os sistemas de monitoramento em tempo real ajudam a detectar problemas antes que eles aumentem. As ferramentas de monitoramento automatizadas rastreiam o desempenho do sistema, o uso de recursos e as anomalias na infraestrutura. Quando um problema potencial é identificado - como o uso anormal da CPU ou um disco com falha - os alertas são acionados, permitindo que as equipes de TI ajam rapidamente.
A visibilidade em tempo real do seu ambiente reduz as chances de ser pego de surpresa por falhas no sistema ou gargalos de desempenho. Com a análise preditiva, algumas plataformas de monitoramento podem até mesmo sinalizar problemas antes que eles afetem as operações.
Realizar manutenção e atualizações regulares do sistema
Os sistemas se degradam com o tempo, e software ou hardware desatualizados introduzem riscos. A manutenção regular garante que a infraestrutura permaneça saudável e segura. Isso inclui a aplicação de patches de segurança, atualizações de firmware e upgrades de software para tratar de vulnerabilidades e manter a compatibilidade.
A manutenção preventiva também ajuda a detectar sinais de desgaste, erros de sistema ou componentes com falhas. Ao resolver esses problemas de forma proativa, as empresas podem evitar interrupções repentinas e melhorar a confiabilidade geral.
Treine os funcionários para minimizar o erro humano
O erro humano continua sendo uma das causas mais comuns - e evitáveis - de tempo de inatividade. Erros, como a configuração incorreta das definições de rede, a exclusão de arquivos críticos ou a aplicação incorreta de atualizações, podem derrubar os sistemas inesperadamente.
Para reduzir esse risco, as empresas devem oferecer treinamento contínuo para todos os funcionários, especialmente aqueles responsáveis pelo gerenciamento de sistemas e redes de TI. Documentação clara, controles de acesso e processos padronizados ajudam a criar um ambiente estruturado onde é menos provável que ocorram erros. Cursos regulares de atualização e treinamento baseado em cenários podem reforçar ainda mais a conscientização.
Desenvolver uma estratégia abrangente de BCDR
Mesmo com medidas preventivas rigorosas, algumas interrupções são inevitáveis. É aí que uma estratégia de continuidade de negócios e recuperação de desastres (BCDR) se torna fundamental. Um plano de BCDR bem elaborado define como a empresa reagirá às interrupções e com que rapidez as operações poderão ser restabelecidas.
Esse plano deve identificar os sistemas essenciais à missão, estabelecer objetivos claros de recuperação (RTO/RPO) e definir funções e responsabilidades durante uma crise. Deve também incluir procedimentos detalhados de comunicação para manter as equipes internas, os clientes e os parceiros informados durante os incidentes.
Ao incorporar o BCDR em suas operações comerciais, você pode limitar o tempo de inatividade e recuperar-se com confiança quando ocorrerem interrupções.
Minimize o tempo de inatividade com o Datto BCDR
O tempo de inatividade pode ser inevitável, mas a rapidez com que uma empresa se recupera está sob seu controle. As ferramentas e o planejamento corretos fazem a diferença entre horas de interrupção e uma recuperação rápida e perfeita.
O Datto BCDR foi criado especificamente para ajudar os MSPs e as equipes de TI a se manterem resilientes contra o tempo de inatividade. Ele combina backup automatizado, failover instantâneo e verificação integrada para reduzir o tempo de inatividade e manter as operações em funcionamento, não importa o que aconteça.
Veja como o Datto BCDR ajuda as empresas a manter o tempo de atividade e a continuidade:
- Backups automatizados: a Datto realiza backups dos dados a cada cinco minutos, garantindo que você sempre tenha um ponto de recuperação recente e minimizando o risco de perda de dados.
- Virtualização instantânea, localmente ou na nuvem: caso os sistemas deixem de funcionar, a Datto pode virtualizá-los instantaneamente — no local, na nuvem ou em ambos — para que as operações possam ser retomadas em questão de minutos.
- Verificação automatizada de backups: Cada backup é testado automaticamente para garantir que ele seja inicializado com sucesso e que os aplicativos e serviços funcionem conforme o esperado.
- Opções flexíveis de recuperação: seja para restaurar um único arquivo, uma pasta ou um ambiente inteiro, a Datto oferece a você controle total sobre como realizar a recuperação.
Com o Datto BCDR, as empresas não estão apenas preparadas para períodos de inatividade; elas também estão equipadas para se recuperar rapidamente e manter as operações funcionando sem interrupções. Conheça o Datto BCDR e descubra como ele mantém as empresas resilientes a ameaças cibernéticas em todos os momentos.




