¿Qué es el tiempo de inactividad? Impacto, costos y cómo reducirlo
Las expectativas de los clientes han cambiado. Hoy en día, la gente espera tener acceso instantáneo a los servicios digitales, en cualquier momento y en cualquier lugar. Si una empresa se queda sin conexión, aunque sea por poco tiempo, corre el riesgo de perder la confianza de los clientes, ingresos y productividad. Es por eso que el tiempo de inactividad se ha convertido en una amenaza existencial significativa para las empresas, especialmente para las pequeñas y medianas empresas (PYMES). Incluso unas pocas horas de interrupción pueden causarles un daño duradero.
Mientras tanto, amenazas como los ciberataques, las fallas de hardware y las interrupciones del sistema se han vuelto cada vez más comunes, lo que hace que sea más difícil que nunca para las empresas mantener la continuidad operativa. En este artículo, analizaremos qué significa realmente el tiempo de inactividad para las empresas y por qué ocurre. También examinaremos el costo financiero y de reputación que puede acarrear y cómo mitigar su impacto mediante una planificación estratégica de continuidad de negocios y recuperación ante desastres (BCDR).
¿Qué es el tiempo de inactividad?
El tiempo de inactividad se refiere a cualquier período en el que los sistemas, las aplicaciones o las redes no están disponibles o no funcionan como se espera. Esta interrupción puede afectar las operaciones internas, las interacciones con los clientes o ambas cosas. Incluso unos pocos segundos de tiempo de inactividad pueden afectar la productividad, los ingresos y la experiencia del usuario.
El tiempo de inactividad puede ser planificado, como en el caso del mantenimiento programado, o imprevisto debido a problemas como fallas de hardware, errores de software o ciberataques. Si bien las empresas buscan maximizar el tiempo de actividad, el tiempo de inactividad ocasional es inevitable. La clave radica en la rapidez y eficacia con que una empresa puede responder y recuperarse ante la adversidad.
Tipos de tiempo de inactividad
El tiempo de inactividad se divide en dos categorías principales: planificado y no planificado. Si bien ambos interrumpen las operaciones normales, difieren en cómo ocurren y en cómo pueden responder las empresas. Comprender esta distinción ayuda a las organizaciones a prepararse para las interrupciones rutinarias y a responder rápidamente a las inesperadas.
Tiempo de inactividad programado
El tiempo de inactividad planificado se programa con anticipación para realizar tareas esenciales, como mantenimiento, actualizaciones o aplicación de parches. Dado que se prevé con antelación, las empresas pueden controlar cuándo y cómo se lleva a cabo —por lo general, durante las horas de menor actividad— para reducir su impacto en la productividad y la experiencia del usuario.
Entre las razones más comunes para un tiempo de inactividad planificado se incluyen:
- Actualizaciones del sistema
- Mantenimiento rutinario
- Cambios en la infraestructura o migración de datos
- Parches de seguridad
Con una planificación y comunicación adecuadas, el tiempo de inactividad programado se puede gestionar con una interrupción mínima.
Tiempo de inactividad no planificado
Las interrupciones no planificadas ocurren sin previo aviso y suelen ser el resultado de fallas inesperadas, eventos externos o incidentes cibernéticos. Estas interrupciones suelen ser más perjudiciales y difíciles de manejar, especialmente si no se cuenta con un plan de recuperación.
Algunos ejemplos de tiempo de inactividad no planificado son:
- Fallas de hardware
- Errores o fallos del software
- Cortes de energía
- Fenómenos meteorológicos extremos como incendios forestales, inundaciones y huracanes
- Ciberataques como el ransomware
El tiempo de inactividad no planificado puede provocar una parálisis operativa, la pérdida de ingresos y el deterioro de la confianza de los clientes, especialmente si la recuperación se retrasa.
Principales causas de tiempo de inactividad
Las interrupciones no planificadas pueden ocurrir sin previo aviso y afectar las operaciones comerciales a cualquier escala. Comprender las causas más comunes es fundamental tanto para la prevención como para una recuperación más rápida. Desde problemas técnicos hasta eventos naturales, saber dónde se encuentran las vulnerabilidades ayuda a las empresas a fortalecer sus defensas y mantener el tiempo de actividad.
Fallo de hardware y software
Los servidores, los sistemas de almacenamiento y los dispositivos de red pueden fallar debido a su antigüedad, a una sobrecarga o a una configuración deficiente. Los problemas de software, como actualizaciones fallidas o aplicaciones incompatibles, también pueden provocar fallos en los sistemas o dañar los datos. Sin redundancia ni supervisión del sistema, incluso una falla menor puede dejar fuera de servicio los servicios esenciales.
Cortes de energía
Los cortes de energía, ya sea por problemas en la red eléctrica local o por condiciones climáticas extremas, pueden detener las operaciones al instante. Las empresas que dependen de una infraestructura local son especialmente vulnerables a los cortes de energía. Las soluciones de energía de respaldo y los sistemas basados en la nube pueden ayudar a mantener el acceso cuando se va la luz.
Ciberataques
Los ataques como el ransomware y los ataques distribuidos de denegación de servicio (DDoS) pueden bloquear los sistemas, corromper los datos y dejar a las empresas sin conexión durante horas o incluso días. A medida que las ciberamenazas crecen en escala y frecuencia, incluso las pequeñas empresas se ven cada vez más afectadas, lo que hace que la planificación de la seguridad y la recuperación sea fundamental.
Error humano
Los errores simples suelen tener consecuencias graves. La eliminación accidental de archivos, los sistemas mal configurados o las actualizaciones mal gestionadas pueden provocar interrupciones del servicio. La capacitación regular y los protocolos estrictos de gestión de cambios pueden reducir significativamente estos riesgos.
Desastres naturales
Eventos como inundaciones, incendios o huracanes pueden dañar la infraestructura física y provocar interrupciones prolongadas. Las empresas necesitan copias de seguridad en la nube, sistemas de recuperación externos y planes de recuperación ante desastres para garantizar la continuidad ante interrupciones a gran escala.
¿Cómo afecta el tiempo de inactividad a una empresa?
El tiempo de inactividad afecta a mucho más que a los sistemas de TI. Desde la pérdida de ventas hasta el incumplimiento de los objetivos de cumplimiento normativo, interrumpe las operaciones diarias, perjudica la experiencia del cliente y puede causar daños duraderos en toda la empresa. Entre las principales preocupaciones se incluyen:
- Pérdida de productividad e ingresos: Cuando los sistemas dejan de funcionar, el trabajo se detiene. Los empleados no pueden acceder a las herramientas, los clientes no pueden realizar compras y los equipos de servicio se ven obligados a improvisar soluciones. Ya sea un error en el proceso de pago de un sitio de comercio electrónico o una línea de producción paralizada, cada minuto sin servicio puede significar una pérdida de ingresos y tiempo desperdiciado.
- Daño a la reputación: Los clientes esperan un servicio rápido y confiable. Las interrupciones frecuentes o prolongadas pueden minar rápidamente la confianza y llevar a los clientes a cambiarse a la competencia. Recuperar la reputación después de una interrupción en el servicio público puede llevar tiempo y, a menudo, implica un costo elevado.
- Incumplimiento de los acuerdos de nivel de servicio (SLA) y de las normas de cumplimiento: Muchas empresas operan bajo acuerdos de nivel de servicio (SLA) que exigen un tiempo de actividad y una confiabilidad constantes. El tiempo de inactividad puede provocar incumplimientos de los SLA, sanciones económicas o la pérdida de contratos. En sectores regulados, también puede poner en riesgo el cumplimiento normativo, lo que expone a la empresa a multas o consecuencias legales.
El costo del tiempo de inactividad
El tiempo de inactividad tiene un alto costo, no solo en términos de ingresos perdidos, sino también en productividad, esfuerzos de recuperación y daño a la reputación a largo plazo. Estos costos directos e indirectos pueden acumularse rápidamente, especialmente para las empresas que dependen de la disponibilidad constante de sus sistemas. Cuantificar estos riesgos ayuda a los líderes empresariales a tomar decisiones informadas sobre la inversión en soluciones de prevención y recuperación.
Cómo calcular el costo del tiempo de inactividad
Una forma sencilla de calcular el impacto financiero del tiempo de inactividad es:
Costo del tiempo de inactividad = (Ingresos perdidos + Productividad perdida + Costos de recuperación + Costos intangibles) × Duración de la interrupción
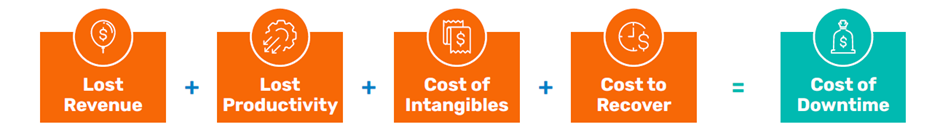
Fig. 1: Costo del tiempo de inactividad para las empresas
Cada parte de esta fórmula desempeña un papel:
- Ingresos perdidos: ventas o transacciones que no se realizaron durante el período de interrupción del servicio.
- Pérdida de productividad: los salarios de los empleados pagados durante el tiempo de inactividad cuando los sistemas están fuera de servicio.
- Costos de recuperación: Gastos relacionados con reparaciones de emergencia, soporte de TI y horas extras.
- Costos intangibles: Daño a la marca, pérdida de clientes y oportunidades futuras perdidas.
El perfil de costos de cada organización es diferente, pero los informes del sector indican que el tiempo de inactividad puede costarle a las pymes entre miles y millones de dólares al día, dependiendo del tamaño, el sector y la dependencia del sistema.
Para comprender cómo el tiempo de inactividad podría afectar a tu empresa o a la de tus clientes, prueba a hacer los cálculos con la Calculadora de tiempo de recuperación y costo del tiempo de inactividad. Tener una visión clara del impacto financiero facilita la priorización de la planificación de la continuidad del negocio.
Cómo reducir el tiempo de inactividad
Minimizar el tiempo de inactividad se reduce a incorporar resiliencia en cada capa de su infraestructura. Desde el mantenimiento preventivo hasta la recuperación rápida, un enfoque proactivo garantiza que su negocio siga funcionando, incluso cuando se producen interrupciones. A continuación se presentan estrategias esenciales que toda organización debería adoptar para reducir el riesgo y el impacto del tiempo de inactividad.
Implementar sistemas de redundancia y conmutación por error
La redundancia es la primera línea de defensa contra las fallas del sistema. Al duplicar componentes críticos —como servidores, dispositivos de almacenamiento o rutas de red—, las empresas se aseguran de que las operaciones puedan continuar incluso si falla el sistema principal. Las soluciones de conmutación por error van más allá al cambiar automáticamente las operaciones a sistemas de respaldo cuando se detectan problemas.
Por ejemplo, si un servidor principal falla, un sistema de conmutación por error redirige inmediatamente las operaciones a un servidor secundario sin necesidad de intervención manual. Los sistemas de conmutación por error basados en la nube son particularmente eficaces, ya que proporcionan entornos de respaldo escalables que garantizan la continuidad ininterrumpida del servicio.
Realice copias de seguridad frecuentes y verifique la capacidad de recuperación
Las copias de seguridad son esenciales, pero su verdadero valor radica en la rapidez y fiabilidad con que se pueden restaurar. Las empresas deben programar copias de seguridad automáticas de todos los datos y aplicaciones críticos, idealmente a diario o incluso cada hora, dependiendo de sus necesidades operativas. Estas copias de seguridad deben almacenarse tanto en las instalaciones como fuera de ellas para protegerse contra fallas locales o desastres.
Igualmente importante es verificar la capacidad de recuperación. Realice pruebas periódicas de sus copias de seguridad para asegurarse de que los datos se puedan restaurar en plazos aceptables. Esto garantiza que, en caso de una falla, pueda reanudar las operaciones sin pérdidas significativas de datos ni tiempos de inactividad.
Aproveche la supervisión automatizada en tiempo real
Los sistemas de monitoreo en tiempo real ayudan a detectar problemas antes de que se agraven. Las herramientas de monitoreo automatizado realizan un seguimiento del rendimiento del sistema, el uso de recursos y las anomalías en toda la infraestructura. Cuando se identifica un posible problema, como un uso anormal de la CPU o un disco defectuoso, se activan alertas que permiten a los equipos de TI actuar rápidamente.
La visibilidad en tiempo real de su entorno reduce las posibilidades de que le tomen por sorpresa los fallos del sistema o los cuellos de botella en el rendimiento. Gracias al análisis predictivo, algunas plataformas de monitoreo pueden incluso señalar problemas antes de que afecten a las operaciones.
Realizar mantenimiento y actualizaciones periódicas del sistema
Los sistemas se deterioran con el tiempo, y el software o hardware obsoleto genera riesgos. El mantenimiento regular garantiza que la infraestructura se mantenga en buen estado y segura. Esto incluye la aplicación de parches de seguridad, actualizaciones de firmware y actualizaciones de software para solucionar vulnerabilidades y mantener la compatibilidad.
El mantenimiento preventivo también ayuda a detectar signos de desgaste, errores del sistema o componentes defectuosos. Al resolver estos problemas de manera proactiva, las empresas pueden evitar interrupciones repentinas y mejorar la confiabilidad general.
Capacite a los empleados para minimizar los errores humanos
El error humano sigue siendo una de las causas más comunes —y evitables— de las interrupciones del servicio. Errores como una configuración incorrecta de la red, la eliminación de archivos críticos o la aplicación incorrecta de actualizaciones pueden provocar caídas inesperadas de los sistemas.
Para mitigar este riesgo, las empresas deben ofrecer capacitación continua a todos los empleados, especialmente a aquellos responsables de la gestión de los sistemas y redes de TI. Una documentación clara, controles de acceso y procesos estandarizados ayudan a crear un entorno estructurado en el que es menos probable que se produzcan errores. Los cursos de actualización periódicos y la capacitación basada en escenarios pueden reforzar aún más la concienciación.
Desarrollar una estrategia integral de BCDR
Incluso con medidas preventivas sólidas, algunas interrupciones son inevitables. Es ahí donde una estrategia de continuidad de negocios y recuperación ante desastres (BCDR) se vuelve fundamental. Un plan de BCDR bien diseñado describe cómo responderá la empresa ante las interrupciones y con qué rapidez se pueden restablecer las operaciones.
Este plan debe identificar los sistemas críticos para la misión, establecer objetivos claros de recuperación (RTO/RPO) y asignar funciones y responsabilidades durante una crisis. También debe incluir procedimientos detallados de comunicación para mantener informados a los equipos internos, a los clientes y a los socios durante los incidentes.
Al integrar BCDR en sus operaciones comerciales, puede reducir el tiempo de inactividad y recuperarse con confianza cuando se produzcan interrupciones.
Minimice el tiempo de inactividad con Datto BCDR
El tiempo de inactividad puede ser inevitable, pero la rapidez con la que una empresa se recupera está bajo su control. Las herramientas adecuadas y una buena planificación marcan la diferencia entre horas de interrupción y una recuperación rápida y sin contratiempos.
Datto BCDR está diseñado específicamente para ayudar a los MSP y a los equipos de TI a mantenerse resilientes frente al tiempo de inactividad. Combina copias de seguridad automatizadas, conmutación por error instantánea y verificación integrada para reducir el tiempo de inactividad y mantener las operaciones en funcionamiento sin importar lo que surja.
Así es como Datto BCDR ayuda a las empresas a mantener el tiempo de actividad y la continuidad:
- Copias de seguridad automáticas: Datto realiza copias de seguridad de los datos cada cinco minutos, lo que garantiza que siempre cuentes con un punto de recuperación reciente y minimiza la posibilidad de pérdida de datos.
- Virtualización instantánea, localmente o en la nube: si los sistemas dejan de funcionar, Datto puede virtualizarlos al instante —en el sitio, en la nube o en ambos— para que las operaciones puedan reanudarse en cuestión de minutos.
- Verificación automática de copias de seguridad: Cada copia de seguridad se prueba automáticamente para garantizar que se inicie correctamente y que las aplicaciones y los servicios funcionen como se espera.
- Opciones flexibles de recuperación: ya sea que necesites recuperar un solo archivo, una carpeta o todo un entorno, Datto te ofrece control total sobre cómo realizar la recuperación.
Con Datto BCDR, las empresas no solo están preparadas para los tiempos de inactividad, sino que también cuentan con lo necesario para recuperarse rápidamente y mantener sus operaciones funcionando sin problemas y sin interrupciones. Explora Datto BCDR para descubrir cómo mantiene a las empresas resilientes frente a las amenazas cibernéticas en todo momento.




